
La plupart des projets d’intelligence artificielle ne meurent pas pendant leur développement. Ils meurent après : au moment précis où quelqu’un, dans un comité de direction, doit décider de mettre l’outil entre les mains de vrais utilisateurs, sur de vraies données, avec de vrais enjeux de sécurité et de continuité. C’est à cet instant que la démonstration impressionnante devient soit un produit, soit un rapport d’incident.
Les chiffres confirment ce que beaucoup de directions techniques vivent en silence. Gartner prévoyait dès 2024 que 30 % des projets d’IA générative seraient abandonnés après la preuve de concept avant la fin de 2025, non pas faute de bonne idée, mais faute de fondations suffisantes pour aller plus loin. Une étude publiée en 2025 par le MIT NANDA va plus loin encore : 95 % des pilotes d’IA générative en entreprise ne génèrent aucun retour sur investissement mesurable. Dans les deux cas, la cause identifiée n’est presque jamais la qualité du modèle. C’est l’écart entre ce qui a été démontré et ce qui était réellement prêt à être exploité.
Pour un CTO, un DSI ou un directeur produit, la question n’est donc plus « notre IA fonctionne-t-elle » : une démo le prouve en quelques minutes. La vraie question est : « notre produit est-il prêt à fonctionner sans nous, tous les jours, sous la charge, sous contrôle, et sous le regard d’un client grand compte » ? C’est cette question que répond la product readiness, et c’est elle qui sépare les projets IA qui restent des démonstrations coûteuses de ceux qui deviennent des produits qu’on peut vendre, opérer et défendre devant un comité d’achat.
Un prototype qui impressionne en comité de direction et un produit que 10 000 utilisateurs peuvent exploiter chaque jour ne sont pas séparés par un peu plus de code. Ils sont séparés par tout ce qu’on ne voit pas dans une démo, et c’est précisément ce que couvre un travail de production readiness.
— Code & Scale
Qu’est-ce qu’une démo IA ne prouve jamais ?
Un prototype d’intelligence artificielle est conçu pour convaincre en trente minutes, devant un public bienveillant, avec un jeu de données choisi. Un produit en production doit tenir sous un usage réel : des données sales, des pics de charge imprévisibles, des utilisateurs qui ne suivent jamais le chemin prévu, et des équipes de sécurité ou de conformité qui posent des questions auxquelles une démo n’a jamais eu à répondre. Ce basculement, de la preuve de concept au produit opéré, est précisément l’endroit où la majorité des projets IA s’arrêtent, souvent sans que personne ne l’ait décidé formellement.
Dans notre expérience, ce risque se repère avant même que le projet ne bloque officiellement, à travers quelques signaux récurrents :
- Le modèle a été validé sur un jeu de données propre et représentatif, mais personne n’a testé son comportement sur les données réelles, incomplètes et bruitées, de la production.
- L’architecture n’a jamais été pensée pour la charge cible : le prototype tourne sur un notebook ou un environnement de test, sans plan de montée en charge ni budget cloud associé.
- La sécurité et la conformité sont traitées comme une case à cocher en fin de projet, alors que les grands comptes et les secteurs régulés les exigent avant toute signature.
- Personne dans l’équipe ne sait répondre à la question « que se passe-t-il si le modèle se trompe, ou s’il dérive dans le temps », faute d’observabilité et de plan de supervision.
- Le produit dépend d’une seule personne pour fonctionner : celle qui l’a construit, et qui est la seule à comprendre comment le relancer en cas d’incident.
Aucun de ces signaux, pris isolément, n’est disqualifiant. Mais laissés sans réponse, ils se traduisent systématiquement par le même scénario : un pilote techniquement convaincant, qui ne franchit jamais le cap de la production, ou pire, qui y arrive et échoue publiquement, devant les utilisateurs qu’il était censé servir.
Notre approche : la readiness comme discipline d’ingénierie, pas comme étape de fin de projet
Avec Code & Scale, l’évaluation de la readiness ne se fait pas la veille de la mise en production. Elle commence dès le cadrage du projet, avec une question simple posée avant tout choix technique : à quel niveau d’exigence ce produit devra-t-il répondre le jour où il sera entre les mains de ses utilisateurs finaux : charge attendue, sensibilité des données, criticité métier, exigences du client si c’est un produit destiné à être vendu ? Cette exigence cible, définie en amont, dicte ensuite les choix d’architecture, de stack et de gouvernance, plutôt que d’être découverte a posteriori quand il est déjà coûteux d’y revenir.
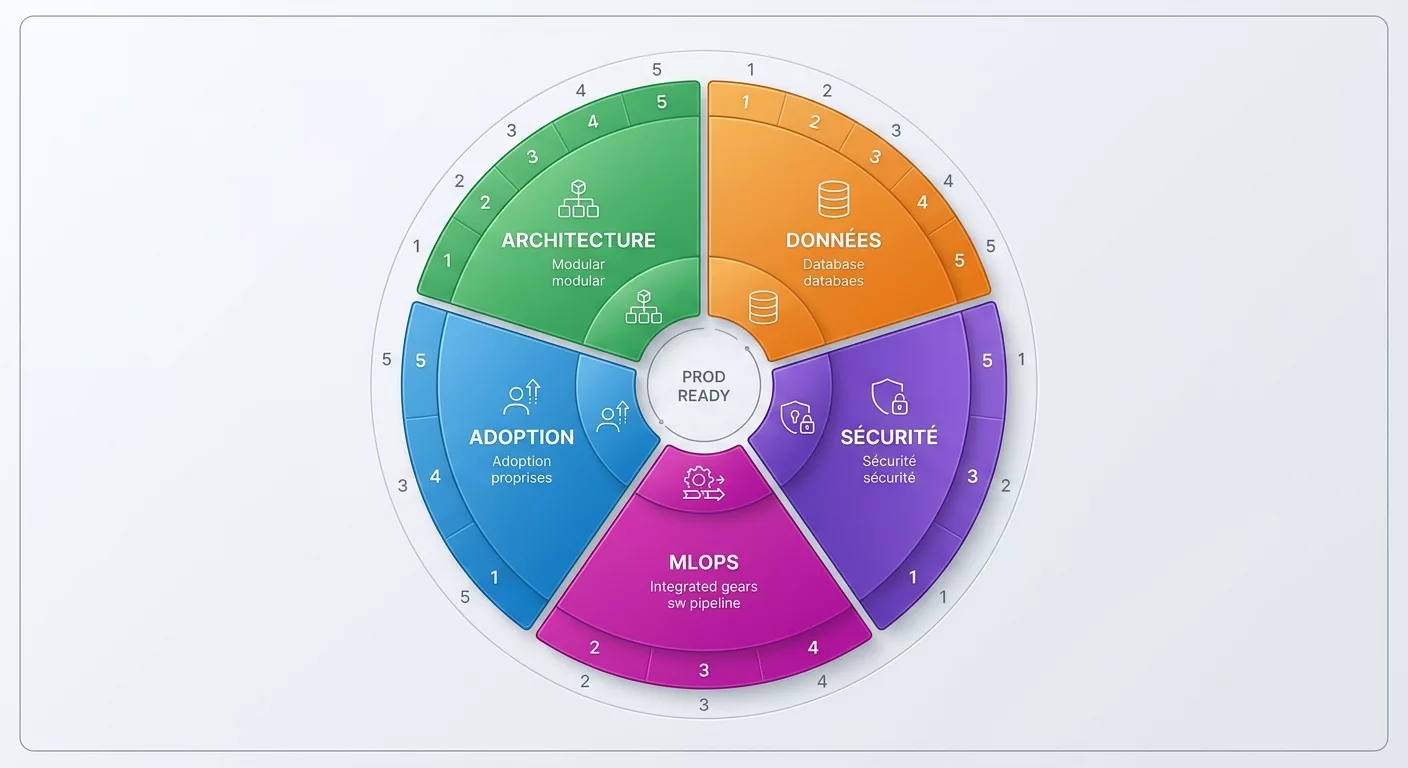
Concrètement, notre grille d’évaluation de la production readiness couvre plusieurs dimensions qui se recoupent rarement dans un audit purement technique : la qualité et la gouvernance de la donnée qui alimente le modèle, la solidité de l’architecture sous charge réelle, la sécurité et la conformité attendues par les clients ou le régulateur, l’observabilité et la capacité à détecter une dérive du modèle une fois en production, et enfin la capacité de l’organisation elle-même à opérer le produit sans dépendre d’une seule personne. Un produit IA n’est pas « prêt » parce que le modèle fonctionne ; il est prêt quand ces cinq dimensions tiennent ensemble.
Ce qui nous différencie n’est pas de savoir construire un modèle qui fonctionne en démonstration : c’est un savoir-faire aujourd’hui répandu. C’est d’avoir construit, opéré et fait évoluer des produits data et IA exploités en continu par des organisations qui n’acceptent pas l’à-peu-près : grands comptes, institutions régulées, plateformes SaaS à forte volumétrie d’utilisateurs. Cette expérience de l’exploitation, pas seulement de la construction, est ce qui nous permet d’anticiper les points de rupture avant qu’ils ne coûtent cher.
Les cinq dimensions d’un produit IA réellement production-ready
Architecture et scalabilité : passer de la démo au produit qui tient la charge
Le problème : un prototype IA tourne souvent sur une architecture pensée pour prouver un concept, pas pour absorber une montée en charge. Le passage de dix utilisateurs pilotes à plusieurs milliers d’utilisateurs actifs révèle des goulots d’étranglement (appels API séquentiels, base de données non dimensionnée, absence de mise en cache) que personne n’avait anticipés parce que personne ne les avait testés.
La solution : concevoir l’architecture (orchestration, files d’attente, séparation des couches de traitement synchrone et asynchrone, choix entre infrastructure serverless et dédiée) en fonction de la charge cible définie dès le cadrage, puis la valider par des tests de charge réels avant, et non après, l’ouverture à l’ensemble des utilisateurs.
La valeur business : une architecture dimensionnée dès le départ évite une refonte technique en urgence au moment précis où le produit commence à générer de la traction commerciale, c’est-à-dire au pire moment possible pour interrompre le service.
Qualité et gouvernance des données : le socle invisible de la readiness
Le problème : un modèle entraîné ou évalué sur un jeu de données propre se comporte rarement de la même façon face aux données réelles : incomplètes, hétérogènes, parfois contradictoires selon leur source. C’est la première cause silencieuse de dérive entre les performances annoncées en phase de test et les performances observées en production.
La solution : cartographier les sources de données réellement mobilisées en production, y compris les plus hétérogènes, formaliser des règles de qualité et de validation à l’entrée des pipelines, et tester le comportement du modèle sur des données représentatives du pire cas, pas seulement du cas moyen.
La valeur business : un produit IA qui reste fiable face à des données imparfaites protège la confiance des utilisateurs dès les premières semaines d’usage. La confiance perdue lors d’un premier incident se regagne beaucoup plus lentement qu’elle ne se construit.
Sécurité et conformité : la readiness que les grands comptes exigent avant de signer
Le problème : un produit IA destiné à des clients grands comptes ou à des secteurs régulés ne se vend pas sur sa performance seule. Il se vend sur la capacité à répondre à un questionnaire de sécurité, à démontrer l’isolation des données par client dans une architecture multi-tenant, et, de plus en plus, à documenter sa conformité au regard de cadres comme le RGPD ou l’AI Act européen. Traiter ces sujets en fin de projet transforme un go-live prévu en plusieurs mois de retard.
La solution : intégrer les exigences de sécurité (gestion des accès, chiffrement, traçabilité des traitements, isolation des données) dans l’architecture dès sa conception, et documenter en continu les choix faits sur les modèles utilisés, leurs limites connues et les garde-fous mis en place, plutôt que de produire cette documentation dans l’urgence au moment où un client grand compte la réclame.
La valeur business : pour un produit destiné à des clients du CAC 40 ou à des institutions régulées, la sécurité et la conformité ne sont pas une contrainte annexe : elles conditionnent directement la capacité à signer, et souvent la vitesse à laquelle un cycle de vente se conclut.
MLOps et observabilité : garder un produit IA fiable après le lancement
Le problème : contrairement à un logiciel classique, un produit IA peut se dégrader silencieusement sans qu’aucune ligne de code n’ait changé : dérive des données d’entrée, évolution des usages, mise à jour d’un modèle tiers. Sans supervision dédiée, cette dégradation n’est découverte que lorsqu’un utilisateur, ou pire un client, la signale.
La solution : mettre en place, avant le lancement, les briques de supervision qui permettent de détecter une dérive du modèle, de suivre les coûts d’inférence à mesure que l’usage grandit, et de déployer les mises à jour sans interruption de service. Ce sont les mêmes disciplines qui ont fait leurs preuves en DevOps appliquées au MLOps, adaptées aux spécificités des systèmes d’IA.
La valeur business : un produit supervisé se corrige en heures plutôt qu’en semaines, et cette différence détermine directement la réputation du produit auprès de ses premiers clients, ceux dont dépend la suite de la trajectoire commerciale.
Adoption et expérience produit : la readiness ne s’arrête pas au code
Le problème : un produit IA techniquement irréprochable peut échouer commercialement s’il exige de ses utilisateurs un effort d’adoption trop élevé, ou si l’organisation qui l’exploite n’a pas de plan pour former, accompagner et faire monter en confiance ses premiers utilisateurs.
La solution : tester le produit avec de vrais utilisateurs finaux avant l’ouverture générale, mesurer explicitement leur niveau de confiance et d’adoption, pas seulement des indicateurs techniques, et prévoir dès le lancement les ressources nécessaires pour accompagner la montée en charge côté utilisateurs, pas uniquement côté infrastructure.
La valeur business : la readiness technique ouvre la porte de la production ; c’est la readiness d’adoption qui détermine si le produit y reste, et s’il devient un actif que les utilisateurs réclament plutôt qu’un outil qu’ils contournent.
Cas concret
Contexte : Un éditeur français développant des plateformes web d’intelligence artificielle, s’est donné pour mission de collecter et structurer massivement des données publiques dispersées sur l’ensemble du territoire français, auprès d’une grande diversité de fournisseurs. Ses clients finaux ne sont pas des équipes techniques tolérantes à l’expérimentation : ce sont des grands comptes du CAC 40 (Bouygues, Veolia, EDF, entre autres) qui exploitent la plateforme en mode SaaS, pour un total de 10 000 utilisateurs actifs. Code & Scale accompagne Explain depuis 2023.
Mission : conception de pipelines et d’API capables d’absorber la diversité et le volume des sources de données publiques françaises ; mise en place d’une plateforme de Data Catalog, avec son interface web et son API ; développement de modèles de post-traitement combinant machine learning et LLM pour structurer et enrichir la donnée collectée. La mission se poursuit aujourd’hui avec le développement d’une plateforme d’agent IA dédiée à la rédaction de documents administratifs.
Résultat : une plateforme en production continue, exploitée quotidiennement par 10 000 utilisateurs actifs au sein de grands comptes exigeants sur la fiabilité, la sécurité et la continuité de service : le passage effectif d’une brique technique à un produit opéré dans la durée par des organisations qui n’acceptent pas l’approximatif.
Technologies : Python, Django, PostgreSQL, ChromaDB, Spacy, Scrapy, PyTorch, OpenAI, Angular, AWS (S3, Serverless, Elastic Beanstalk, Bedrock, SageMaker, SQS).
Valeur créée : une infrastructure de collecte et de traitement de données publiques suffisamment robuste et gouvernée pour être mise, sans réserve, entre les mains d’utilisateurs de grands groupes du CAC 40, là où la plupart des pipelines construits en mode preuve de concept ne survivent pas à ce niveau d’exigence.
« Code & Scale est un partenaire idéal dans le développement de notre produit. »
— Le CTO
Notre vision
Nous ne considérons pas la production comme la ligne d’arrivée d’un projet IA, mais comme le début de sa vraie vie : celle où un produit doit continuer à bien se comporter longtemps après que l’enthousiasme du lancement soit retombé. Cette conviction façonne notre manière de travailler : nous ne livrons pas un modèle qui fonctionne un jour de démonstration, nous construisons des produits conçus pour être opérés, surveillés et améliorés dans la durée.
Cette exigence, nous l’avons construite sur le terrain, pas dans l’abstrait. En tant que cabinet franco-malgache de conseil en ingénierie data & IA, nous travaillons depuis 2018 avec des scale-ups, des grands groupes et des institutions à Madagascar, dans l’Océan Indien et en Europe : des contextes où un produit mal préparé pour la production se paie cash : en confiance perdue auprès d’un premier client stratégique, en refonte technique en urgence, ou en opportunité commerciale manquée. C’est ce terrain qui nous a appris à ne jamais confondre un prototype qui fonctionne avec un produit qui est prêt.
La rigueur que nous mettons dans l’évaluation de la readiness n’est pas un frein imposé à nos clients : c’est ce qui nous permet ensuite de nous engager sur la fiabilité de ce que nous livrons, et de rester leur partenaire technique dans la durée, bien au-delà du jour du lancement.
Avant votre prochaine mise en production
Si votre équipe s’apprête à ouvrir un produit IA à ses premiers utilisateurs réels, internes ou clients, la question à se poser n’est pas « le modèle fonctionne-t-il », mais « avons-nous vérifié, dimension par dimension, que ce produit tiendra sous l’usage, sous la charge et sous le regard de ceux qui vont l’exploiter ». C’est une vérification qui se compte en semaines, quand l’absence de cette vérification se paie en mois de refonte, en confiance perdue, ou en cycle de vente bloqué devant un questionnaire de sécurité auquel personne n’a su répondre.
Vous préparez la mise en production d’un produit data ou IA ? Si vous souhaitez évaluer sa readiness avant de l’ouvrir à vos utilisateurs, échangeons.
Questions fréquentes sur la product readiness IA
Qu’est-ce que la « product readiness » pour un produit IA ?
La product readiness désigne le niveau de préparation d’un produit IA avant sa mise en production : la solidité de son architecture sous charge réelle, la qualité et la gouvernance des données qui l’alimentent, sa conformité en matière de sécurité, sa capacité à être supervisé une fois en production, et la capacité de l’organisation à l’opérer sans dépendre d’une seule personne.
Pourquoi un POC IA ne passe-t-il pas en production ?
La cause la plus fréquente n’est pas la performance du modèle, mais l’écart entre l’environnement contrôlé du prototype et les conditions réelles de la production : données imparfaites, charge d’usage imprévue, exigences de sécurité non anticipées, absence de plan de supervision. Un prototype prouve qu’un modèle fonctionne ; il ne prouve jamais qu’un produit est prêt.
Quels sont les critères d’un audit de production readiness IA ?
Un audit sérieux évalue au minimum cinq dimensions : l’architecture et sa capacité à tenir la charge cible, la qualité et la gouvernance des données réellement mobilisées, la sécurité et la conformité attendues par les clients ou le régulateur, l’observabilité permettant de détecter une dérive du modèle, et la capacité d’adoption par les utilisateurs finaux.
Quelle différence entre MLOps et production readiness ?
Le MLOps regroupe les pratiques et outils qui permettent d’industrialiser et de superviser un modèle en production : déploiement continu, monitoring, gestion des versions. La production readiness est plus large : elle inclut le MLOps, mais aussi l’architecture, la gouvernance des données, la sécurité, la conformité et l’adoption utilisateur : l’ensemble des conditions à réunir avant, pas seulement pendant, l’exploitation en production.
Combien de temps faut-il pour rendre un produit IA production-ready ?
Cela dépend du périmètre, de la criticité du cas d’usage et de l’état initial du produit, mais une évaluation structurée de readiness se compte généralement en semaines. C’est largement plus rapide, et moins coûteux, qu’une refonte technique menée dans l’urgence après un incident de production.
Quels risques si un produit IA est mis en production sans évaluation de readiness ?
Les risques les plus fréquents sont une dégradation silencieuse des performances du modèle, des interruptions de service lors des pics de charge, un blocage commercial face aux exigences de sécurité d’un client grand compte, et une perte de confiance des premiers utilisateurs, souvent la plus difficile à regagner.
Qu’est-ce qu’un « AI Production-Readiness Assessment » ?
C’est une évaluation structurée, menée avant la mise en production d’un cas d’usage IA, qui couvre l’architecture, la donnée, la sécurité, l’observabilité et l’adoption utilisateur, et qui débouche sur un plan d’action priorisé pour combler les écarts identifiés avant l’ouverture aux utilisateurs finaux.
Évaluer la readiness de votre produit IA
Si vous souhaitez évaluer votre situation actuelle avant une mise en production, échangeons.
